一出手就表现惊艳!国产开源大模型又杀出一匹黑马
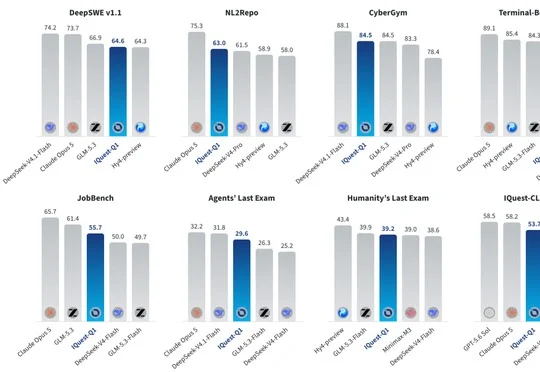
一出手就表现惊艳!国产开源大模型又杀出一匹黑马至知创新研究院开源了采用稀疏 MoE 架构的代码与复杂任务导向大模型 IQuest-Q1,该模型总参数约 320B、激活参数仅约 15B,在代码生成、终端操作、智能体任务等多项评测中表现均衡,并展示了从前端交互、游戏开发到强化学习训练调试等场景的可交付能力。
来自主题: AI资讯
9832 点击 2026-09-30 11:16

 搜索
至知创新研究院开源了采用稀疏 MoE 架构的代码与复杂任务导向大模型 IQuest-Q1,该模型总参数约 320B、激活参数仅约 15B,在代码生成、终端操作、智能体任务等多项评测中表现均衡,并展示了从前端交互、游戏开发到强化学习训练调试等场景的可交付能力。
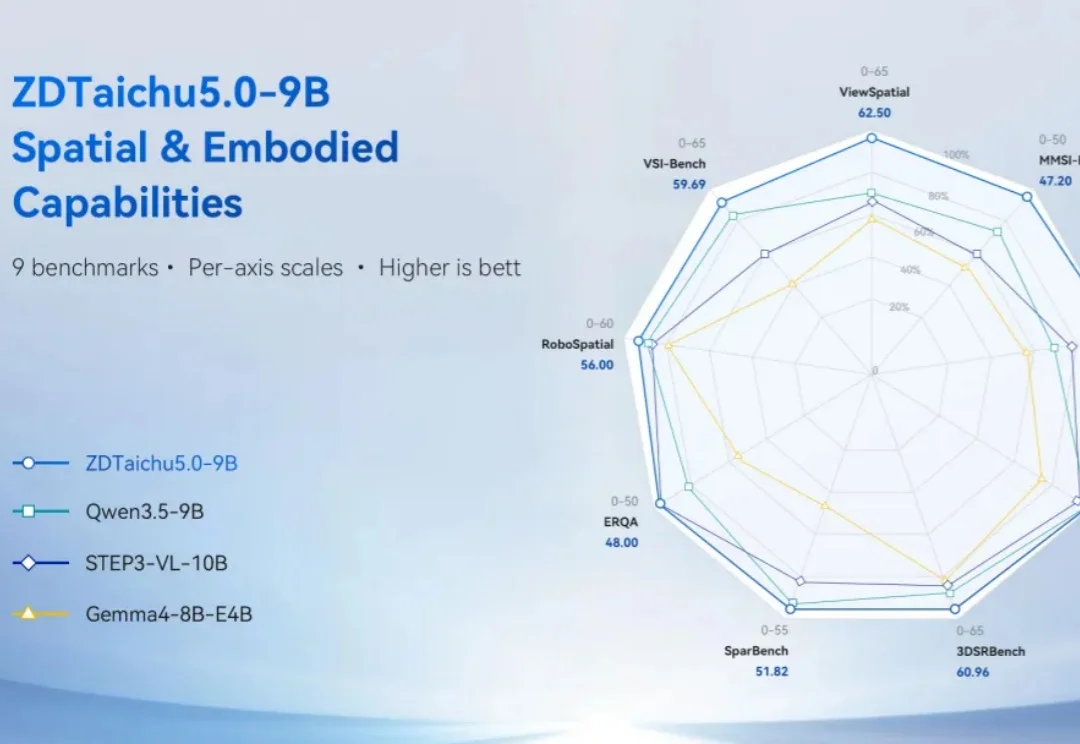
紫东太初开源的这个通用多模态大模型 ZDTaichu5.0-9B,简直夯爆了!
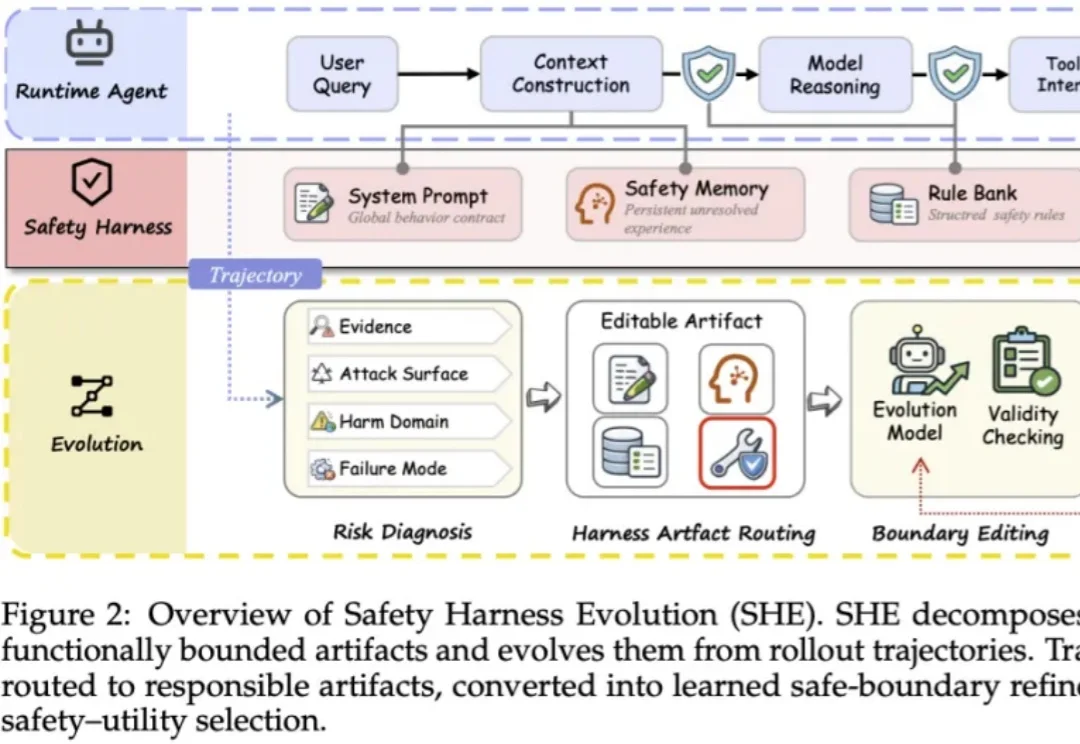
大模型 Agent 进入浏览器、邮件、数据库和业务系统后,安全评估如果仍只检查最终回复是否包含有害内容,覆盖面会明显不足。Agent 需要规划步骤、读取外部信息并调用工具,风险可能出现在执行过程中的任一环节。
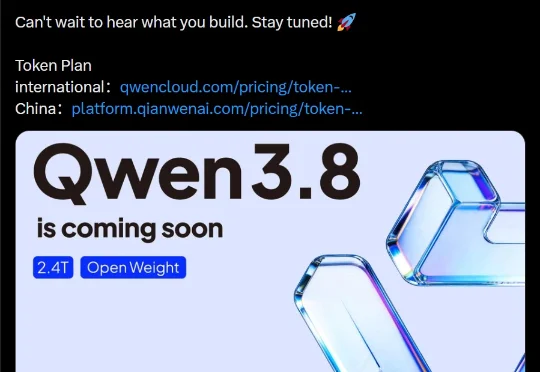
8 月 3 日,阿里巴巴正式发布新一代基座大模型 Qwen3.8,总参数量 2.4 万亿,在编程(Coding)和专业办公(Cowork)方面能力大幅提升。今日放榜的权威三方榜单 Arena 中,阿里 Qwen 模型仅次于 Anthropic 的 Claude 系列,整体性能处于全球大模型第一梯队。。
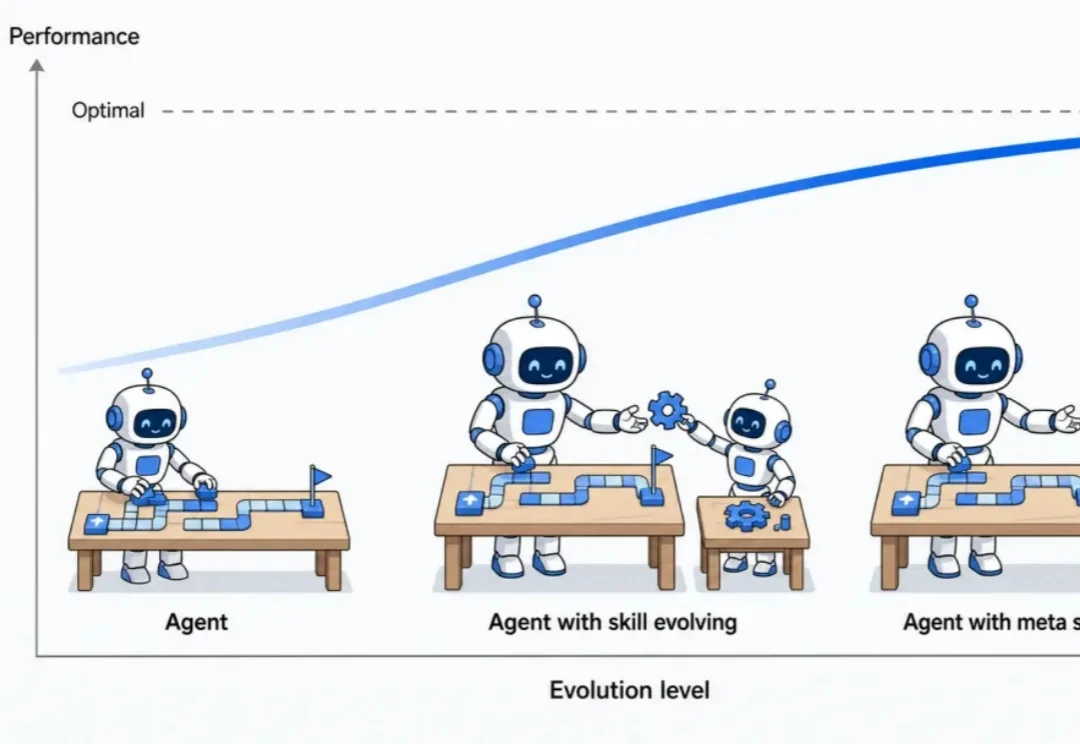
当大模型 Agent 被部署到工具调用、长程任务和开放环境中,一个关键问题会随之出现:能否在不更新模型参数的情况下,将执行经验沉淀下来,并在下一次做得更好?
“ 硅基流动却带亏上市:中美Token中间商,为何同人不同命?” “中美Token分发商,正在走向两条截然不同的路。”某国产大模型厂商的 API 生态负责人王栋告诉雷峰网。近日,全球头部大模型 API 聚合平台 OpenRouter 被曝寻求“卖身”,正与多家科技巨头洽谈收购机会。
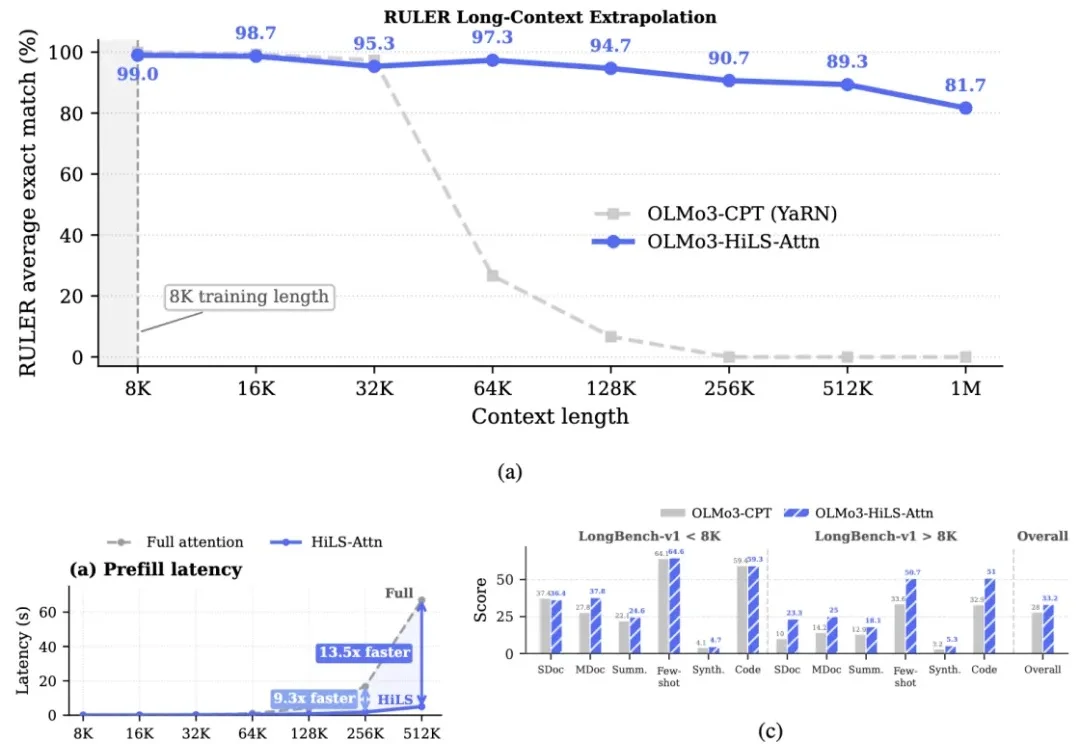
让大模型 "读得更长" 一直是 Agent、深度推理和海量资料整合等场景的刚需,但标准全注意力机制的计算量随序列长度呈平方级增长,始终是横亘在长上下文建模面前的三座大山。
推理大模型 (如 DeepSeek-R1、o1) 靠长思维链拿高分,却普遍「想太多」: 研究统计了五个代表性模型里,发现有 41–52% 的 token 是在模型给出它的最终答案之后生成的。
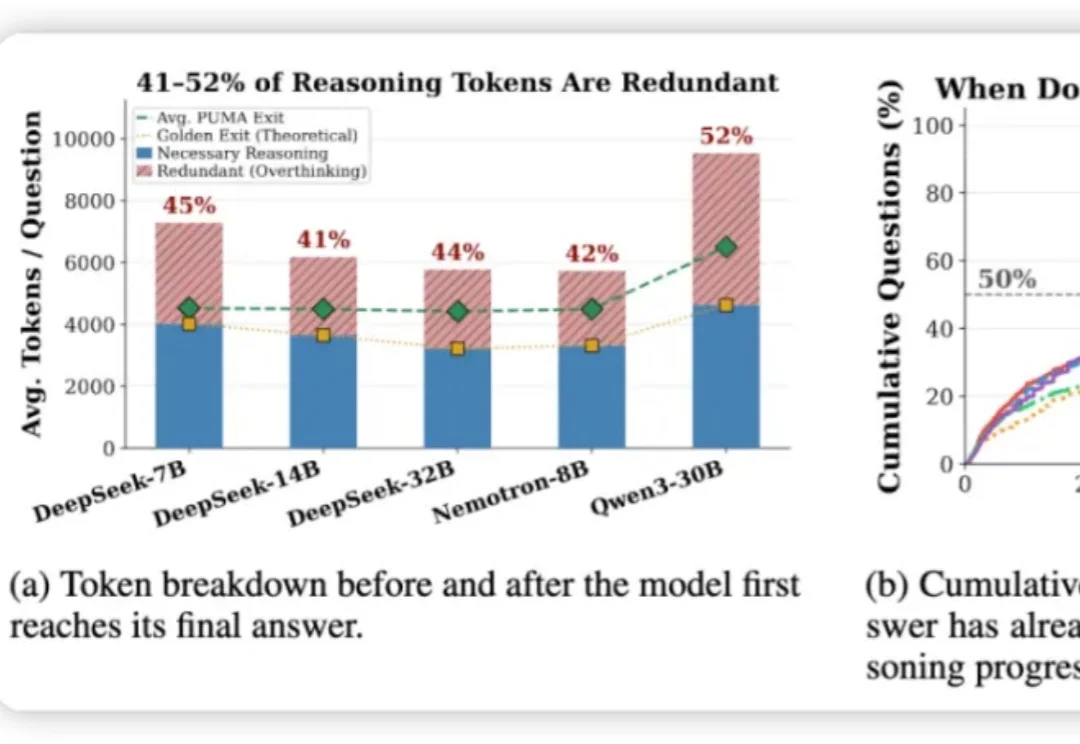
推理大模型 (如 DeepSeek-R1、o1) 靠长思维链拿高分,却普遍「想太多」: 研究统计了五个代表性模型里,发现有 41–52% 的 token 是在模型给出它的最终答案之后生成的。
机器之心编辑部 由 OpenAI 前首席技术官 Mira Murati 创立的 AI 初创公司 Thinking Machines Lab,刚刚发布了自研 AI 模型 Inkling。与 OpenAI、Anthropic 或 Google 的旗舰模型不同,Inkling 是一款开放权重模型,外部开发者和企业可以直接下载,并根据自身需求进行修改。